KI skaliert nicht auf Datenchaos
29. Mai 2026 · 2 Min. Lesezeit
Moderne Sprachmodelle kommen scheinbar mit jedem Chaos zurecht. Warum saubere Datenstrukturen trotzdem die Grundlage bleiben, wenn KI effizient, bezahlbar und nachhaltig skalieren soll.
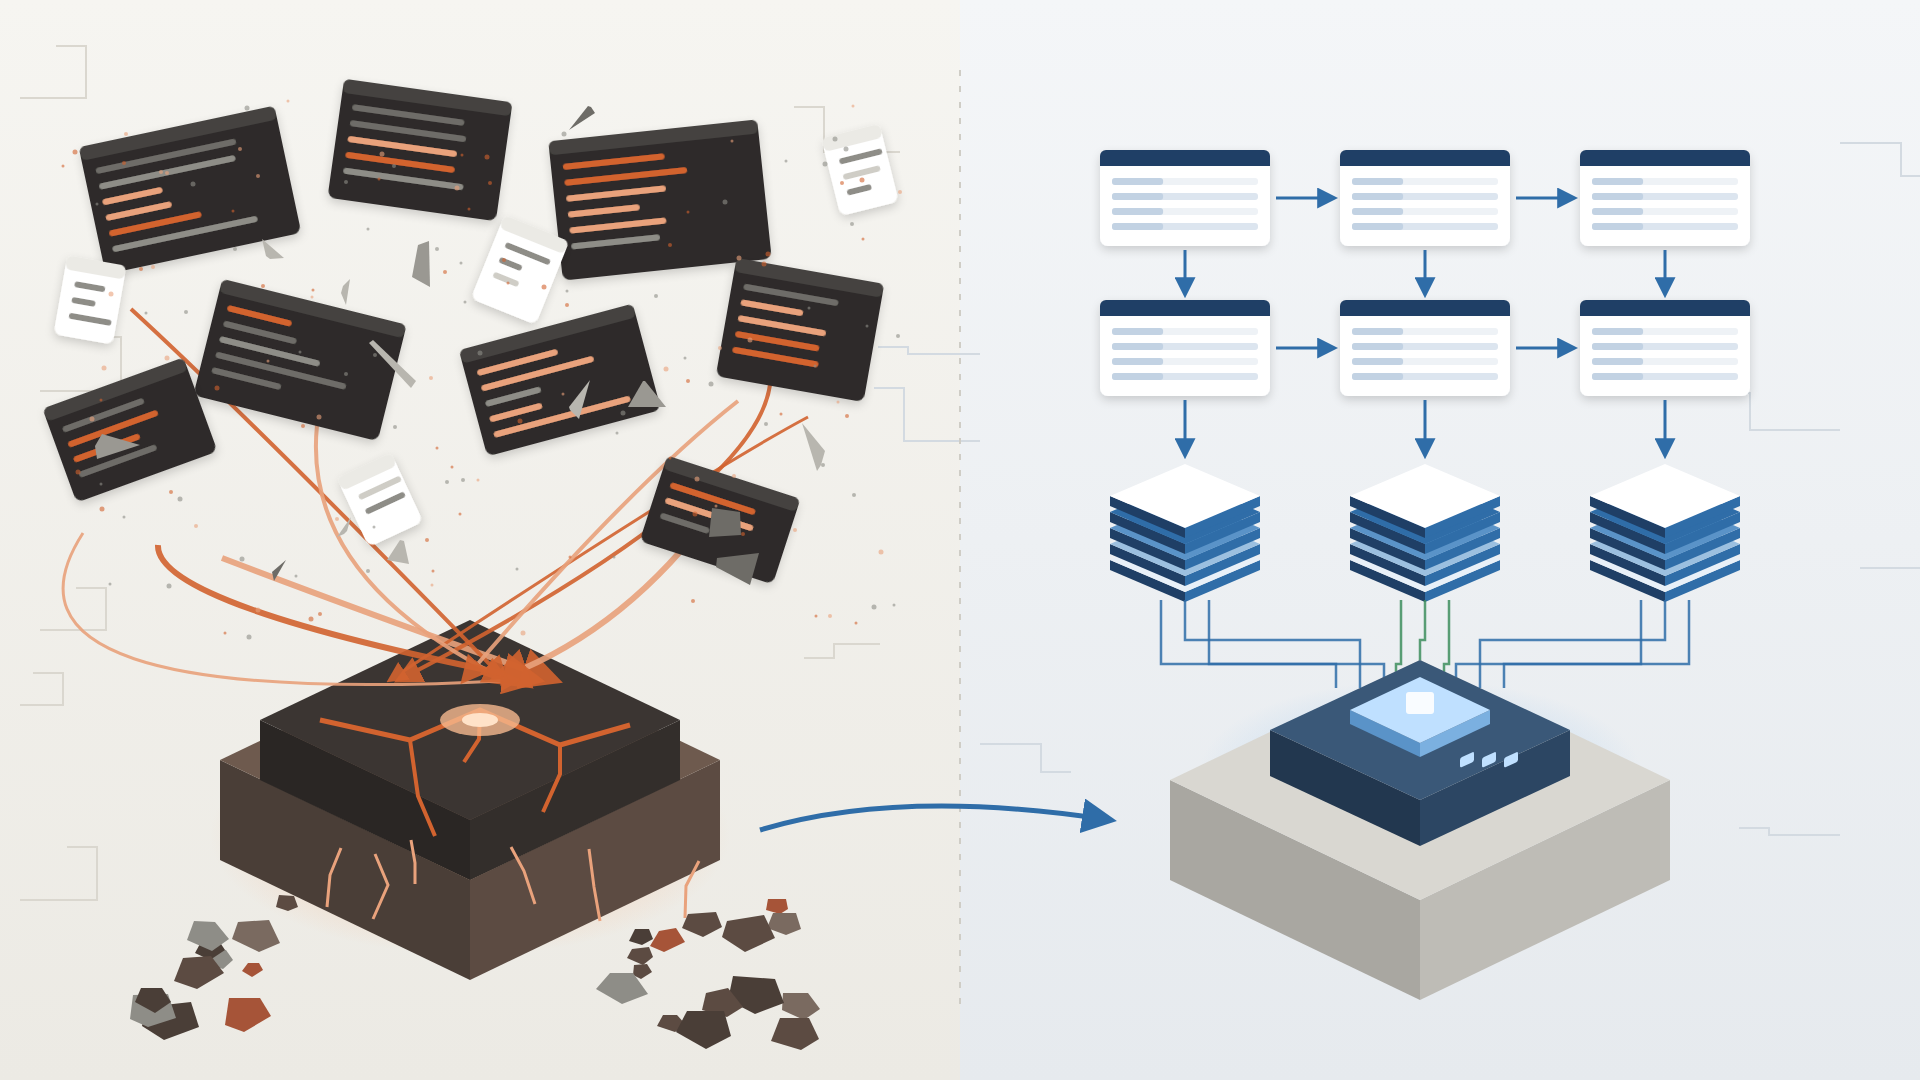
„Wir brauchen keine sauberen Datenstrukturen mehr. Moderne LLMs und Agenten-Architekturen kommen schließlich auch mit absolutem Chaos zurecht.“
Diesen Satz hört man in der Tech-Welt aktuell immer öfter.
Die Argumentation klingt verlockend: Wenn KI komplexe ETL-Pipelines selbst baut, über MCP kommuniziert und Webseiten wie ein Mensch bedient, warum sollten wir dann noch Zeit in saubere Daten investieren?
Ein Blick in die Geschichte der Softwareentwicklung zeigt jedoch, dass wir hier einen bekannten Denkfehler wiederholen.
Machen wir eine kurze Zeitreise:
In den Anfängen der IT war Speicherplatz extrem teuer und Rechenleistung kaum vorhanden. Code musste zwingend auf minimalen Speicher optimiert werden.
Heute ist Speicherplatz billig und im Grunde egal. Dafür sind die benötigte Rechenleistung und die dafür nötige Energie der eigentliche Engpass.
Bei der aktuellen KI-Infrastruktur sehen wir genau diese Dynamik, nur in einer völlig neuen Dimension.
Die neue Währung heißt Energie.
Und Energie ist keine rein digitale Ressource.
Sie ist das am härtesten umkämpfte Gut der analogen Welt. Historisch gesehen wurden und werden um den Zugang zu Energieressourcen globale Konflikte und Kriege geführt.
Staaten sind bereit, immense geopolitische Risiken einzugehen, um ihre Stromversorgung zu sichern.
Wenn Tech-Giganten heute beginnen, eigene Atomkraftwerke zu reaktivieren oder exklusive Deals mit nationalen Stromnetzen zu schließen, wird klar: Die Skalierung von KI ist längst eine Frage der nationalen Sicherheit und globaler Ressourcenkämpfe.
Wer chaotische Daten mit Brute-Force-KI und endlosen Agenten-Schleifen löst, verschwendet also nicht nur Unternehmensbudget. Er verbrennt eine extrem kritische, weltweit umkämpfte Ressource.
Jedes Datenchaos zwingt das Modell zu zusätzlichen Denkschritten, mehr Token und höherem Compute-Bedarf.
Rein systemisch betrachtet ändert sich ein Grundprinzip nie:
Niemand würde ein Haus auf einem Fundament aus losem Schutt bauen, völlig egal wie viel leistungsfähiger die modernen Baumaschinen heute im Vergleich zu früher sind.
Für unsere Informationslandschaften gilt genau dasselbe.
Eine saubere Architektur ist kein Relikt der Vergangenheit. Sie ist in einer Welt begrenzter und umkämpfter Ressourcen die absolute Grundvoraussetzung, um KI-Prozesse effizient, bezahlbar und nachhaltig zu skalieren.
Schlagwörter